前回の記事「コーヒーの味を散文図にする」を書いたのは、2016年3月4日。気づけば10年と7か月が過ぎていました。(タイトルの「散文図」は「散布図」の変換ミスです。10年間、気づかないふりをしていました。)
前回は、コーヒー豆専門店の商品ページにある「甘味・酸味・苦味・コク」の4つの数字を、主成分分析(PCA)で2つにまとめて散布図にしました。結論は、横軸が「味の全体量」、縦軸は「何でしょうコレ?」と、縦軸の意味を説明しきれずに終わっています。
この10年で、機械学習はずいぶん身近になりました。そこで今回の宿題はこの2つです。
- 10年前と同じ主成分分析をやり直したら、同じ地図が描けるのか。縦軸の正体は分かるのか
- ランダムフォレストやニューラルネットワークは、主成分分析では見えなかったものを見せてくれるのか
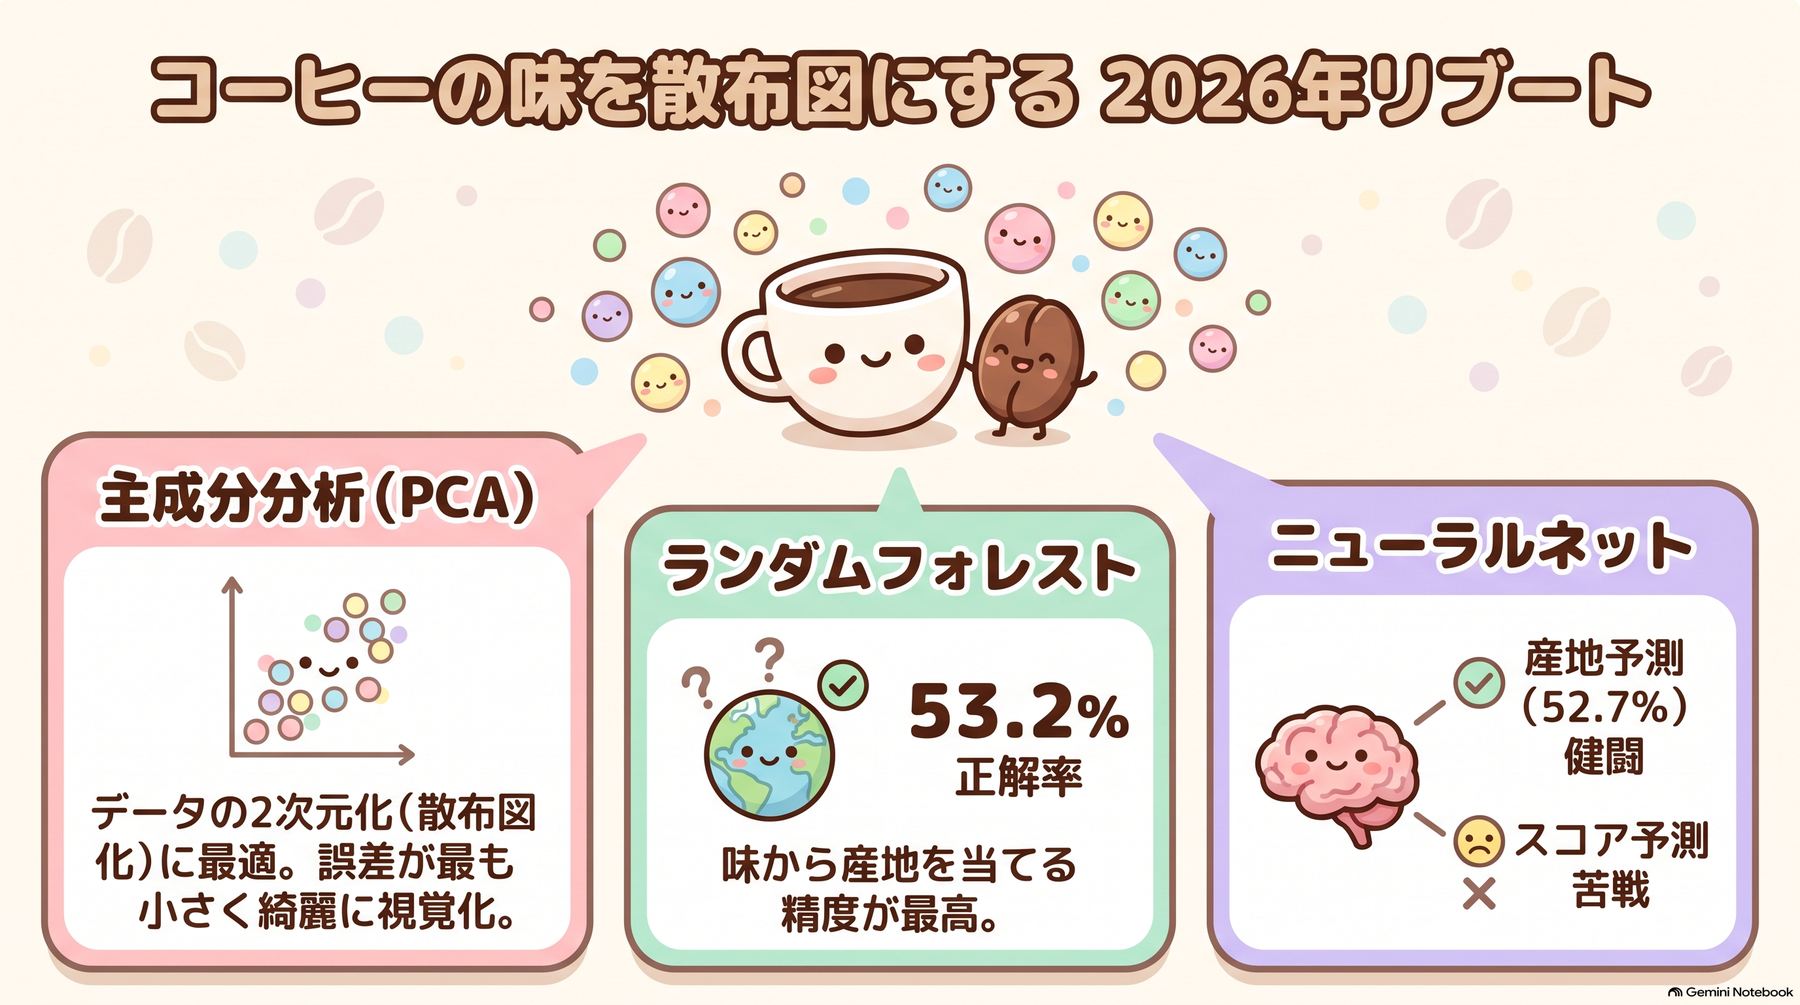
1. 今回使う3つの道具
まず、今回の登場人物(手法)を紹介します。
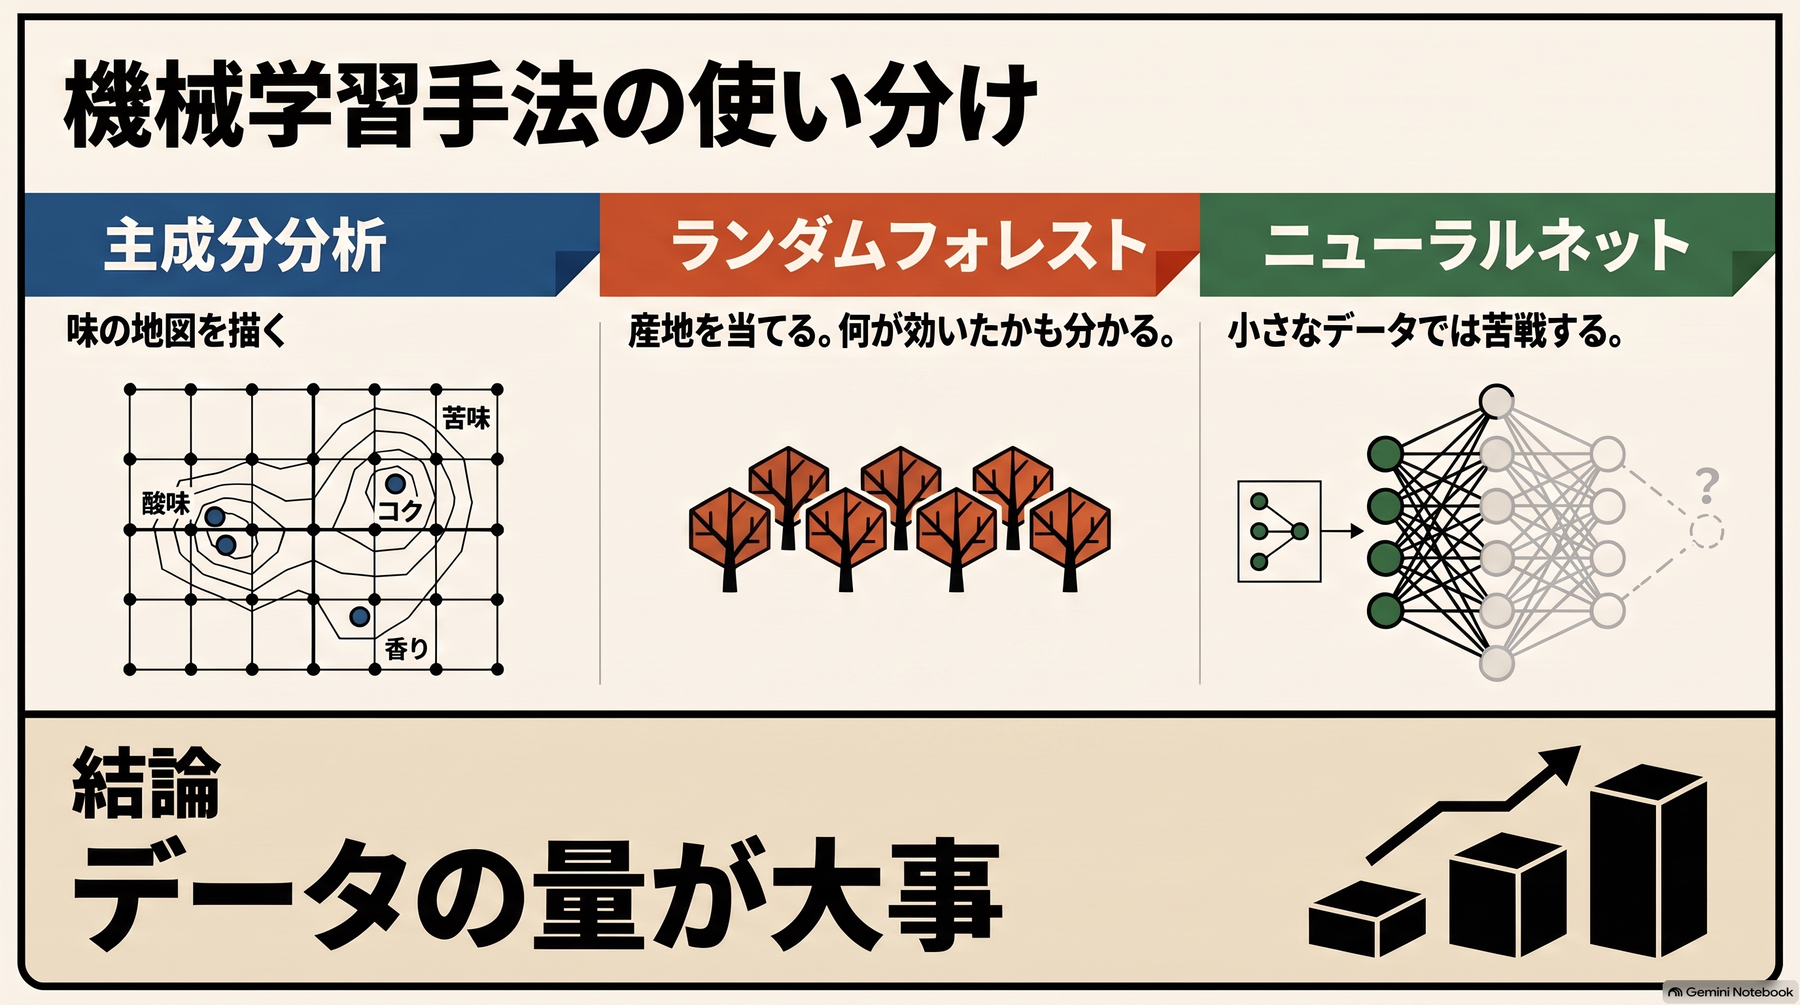
- 主成分分析(PCA):たくさんの数字を、情報をなるべく残したまま2つ程度の軸にまとめます。「味の地図」を描く道具です
- ランダムフォレスト:少しずつ違う決定木(「酸味が3以上か?」のような質問の枝分かれ)を数百本作り、多数決で答えを出します。どの項目が予測に効いたか(変数重要度)も分かります
- ニューラルネットワーク:脳の神経回路をまねた、多層の計算式です。今回は、層が2つの小さなもの(MLP)と、データを2つの数字に圧縮して復元する「オートエンコーダ」を使いました。データが多いほど強い、というのが通説です
「AI」と聞くとニューラルネットワークを思い浮かべがちですが、ここでは3つとも機械学習の手法として並べて、同じ土俵で比べます。
2. 使うデータ:ネットを広く探してみた
前回は、1つの店のデータだけで分析しました。今回は、NotebookLMのDeep Researchに「コーヒーの味を数値化した公開データ」と「その機械学習分析」を探してもらい、33件のソースを集めました。見つかったのは、たとえば次のようなものです。
- Coffee Quality Institute(CQI)のカッピング評価データ(GitHubとKaggleで公開)
- Kaggleの「Coffee Reviews Dataset」(コーヒーレビューの評価)
- CQIの2023年5月版(Kaggleで公開。今回は使っていません)
(小ネタです。調査で「SCA」と書いたところ、NotebookLMが「Supply Chain Analytics」の教科書を要約してきて、コーヒーの話が一行も出てこないレポートが完成しました。SCAはSpecialty Coffee Associationのつもりだったのですが。このレポートは使っていません。)
その中から、自由に取得でき、再現できる2つを選びました。
| 項目 | データA:ワールドビーンズショップ | データB:CQIカッピング評価 |
|---|---|---|
| 何のデータか | 焙煎豆店の商品ページにある「味覚レベル」(★1〜5) | 専門家がカップテスト(カッピング)でつけた点数 |
| 件数 | 187商品(2026年10月に取得) | アラビカ種1,310ロット(2012〜2017年収穫が中心) |
| 味の項目 | 甘み・酸味・苦味・コク(前回と同じ4つ) | アロマ・フレーバー・後味・酸・ボディ・バランスなど(各10点満点、合計が総合点) |
| 点数の意味 | その味が強いか弱いか | その味が良いか悪いか |
| そのほかの情報 | 原産国、品種、精製方法、標高、おすすめ焙煎度 | 原産国、品種、精製方法、標高、収穫年 |
| 出どころ | ワールドビーンズショップ(前回と同じ店) | GitHub公開のCQIデータ |
データAは、商品ページを1.2秒おきに1枚ずつ取得し(212ページ。robots.txtは問題なし)、味の4項目がそろう単品187商品を使いました。ミックスやお試しセット3点は、味の項目に「0」が入っていたため除外しています。データそのものの再配布はしません。
この2つは、同じ「味のデータ」でも意味が違うことに注意してください。データAは「どんな味か(強さ)」、データBは「どれだけ良いか(質)」の点数です。この違いが、あとで効いてきます。
3. 分析1:前回の地図を描き直す(データA、主成分分析)
まず、前回と同じことをします。4つの味(各項目を標準化)を主成分分析にかけて、2次元の散布図にしました。
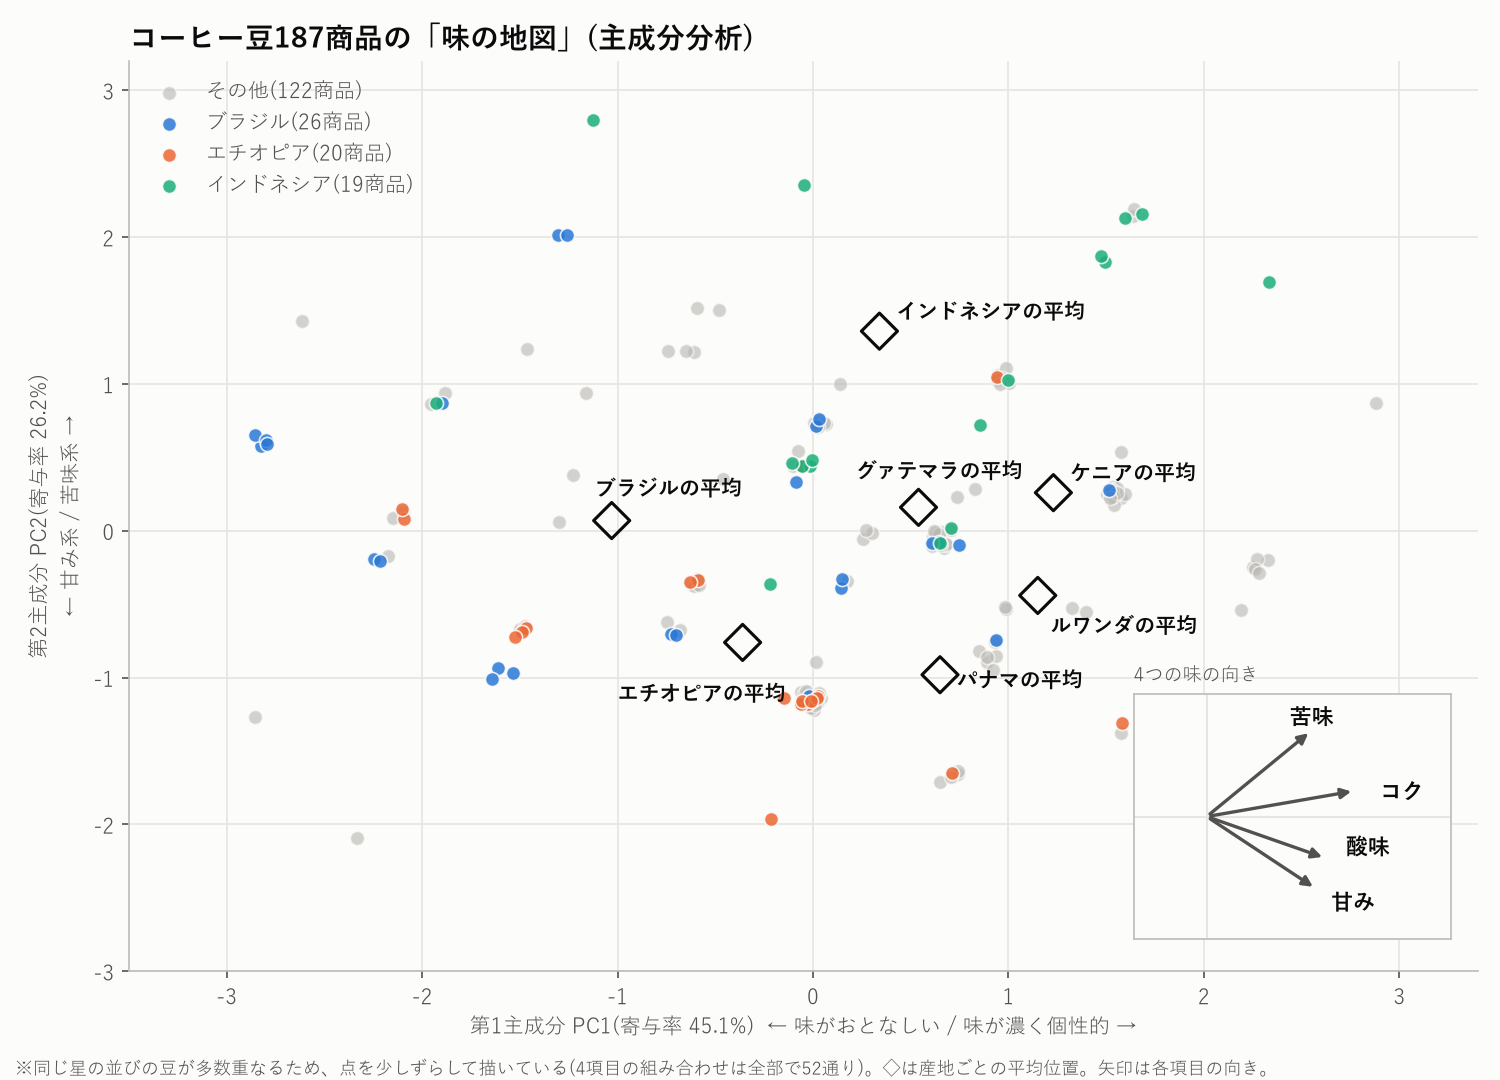
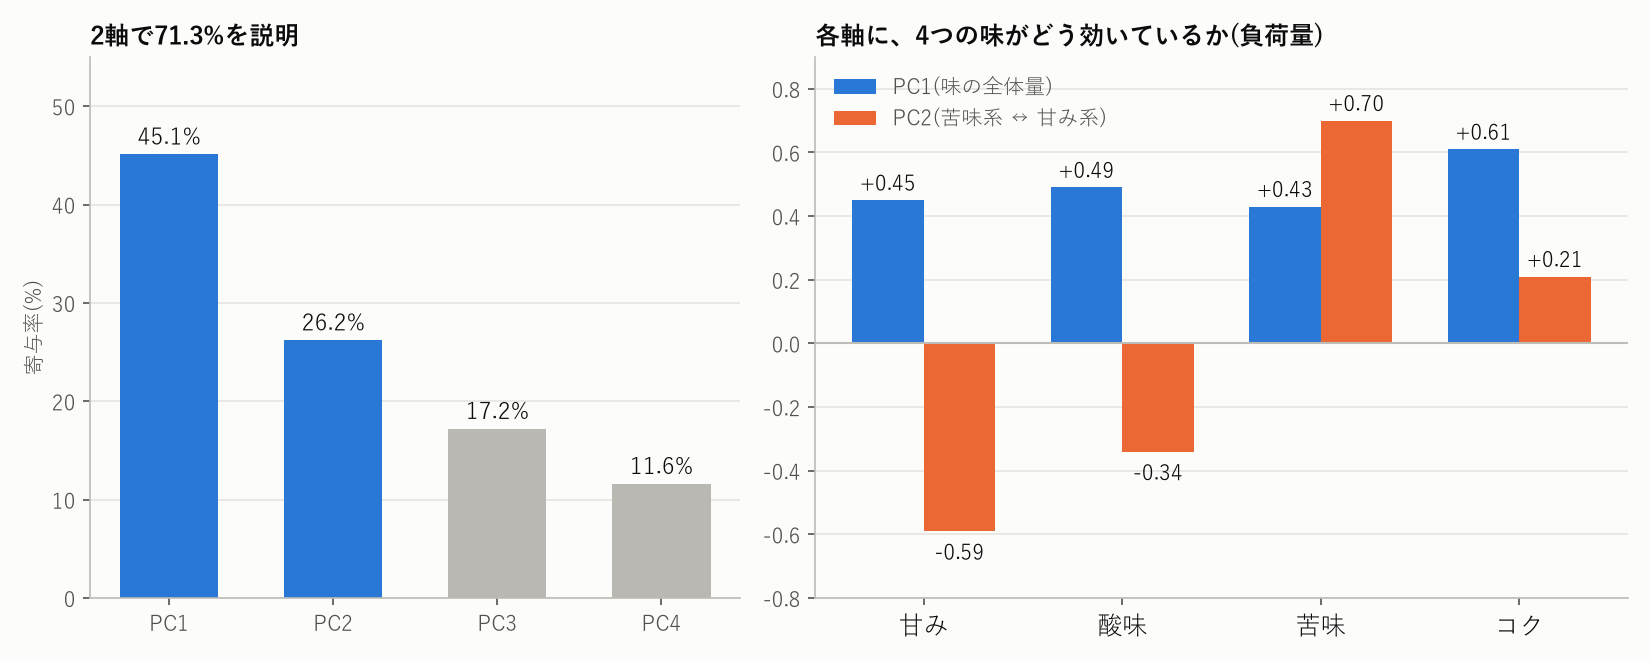
- 第1主成分(横軸、寄与率45.1%):4項目がすべてプラスです(甘み+0.45、酸味+0.49、苦味+0.43、コク+0.61)。つまり「味の全体量」。前回の読みは当たっていました
- 第2主成分(縦軸、寄与率26.2%):苦味が+0.70、甘みが-0.59と、反対向きに効いています。縦軸の正体は「苦味系 ↔ 甘み系」でした。前回は「あっさり系と濃い系?」と迷いましたが、これならスッキリ説明できます
- 2軸で合計71.3%を説明できます
産地ごとの平均位置も見てみます。
- ブラジル(26商品):最も左(横軸-1.03)。味がおとなしい。前回「左はブラジル・コロンビア産」と書いたとおりです
- ケニア(5商品)・ルワンダ(5商品):右端(+1.23、+1.15)。味が濃く個性的
- インドネシア(19商品、マンデリンなど):縦軸の上(+1.36)。苦味系の代表
- パナマ(6商品):縦軸の下(-0.98)。甘み系
- エチオピア(20商品)は、前回の予想「右の個性的な側」とは違い、中央やや左(-0.36)でした。甘み3.5、酸味3.1と高めなのに、苦味2.1、コク2.8が低めだからです。10年前は「右にエチオピア産」と書いていたので、これは外れです
地図に点がこれだけ重なる
図2を見ると、同じ位置に点が団子のように重なっています。実は、187商品のうち、4項目の組み合わせは52通りしかありません。星が5段階では、どうしても同じ並びが多くなります。たとえば「甘み4・酸味3・苦味2・コク4」の商品は7つもあります。
| 商品名(ワールドビーンズショップ、2026年10月時点) | 原産国 | 甘み | 酸味 | 苦味 | コク |
|---|---|---|---|---|---|
| ブラジル トミオ・フクダ DRY ON TREE | ブラジル | 4 | 3 | 2 | 4 |
| タンザニア エーデルワイス AA | タンザニア | 4 | 3 | 2 | 4 |
| グァテマラ アンティグア ピーベリー | グァテマラ | 4 | 3 | 2 | 4 |
| グァテマラ フロレンシア農園 ゲイシャ | グァテマラ | 4 | 3 | 2 | 4 |
| コスタリカ アグリビッド オレンジティピカ ハニー | コスタリカ | 4 | 3 | 2 | 4 |
| コロンビア サンタ・バーバラ Vino7 | コロンビア | 4 | 3 | 2 | 4 |
| ベトナム ファインロブ ランビアン アナエロビック ナチュラル | ベトナム | 4 | 3 | 2 | 4 |
ブラジル、タンザニア、グァテマラ、コスタリカ、コロンビア、ベトナム。産地も豆の品種も精製方法もバラバラなのに、地図の上では完全に同じ点です。前回の最後に書いた「グァテマラが美味しかったから、傾向が似ているタンザニアAAを注文しよう」という使い方は、この表のとおり、実際にできます。ただし、お店の星は5段階なので、地図の解像度はこのくらいが限界です。
4. 分析2:プロのカッピング1,310ロットで同じことをやってみる(データB)
次に、データB(CQI)でも主成分分析をしてみます。アロマ・フレーバー・後味・酸・ボディ・バランスの6項目です。
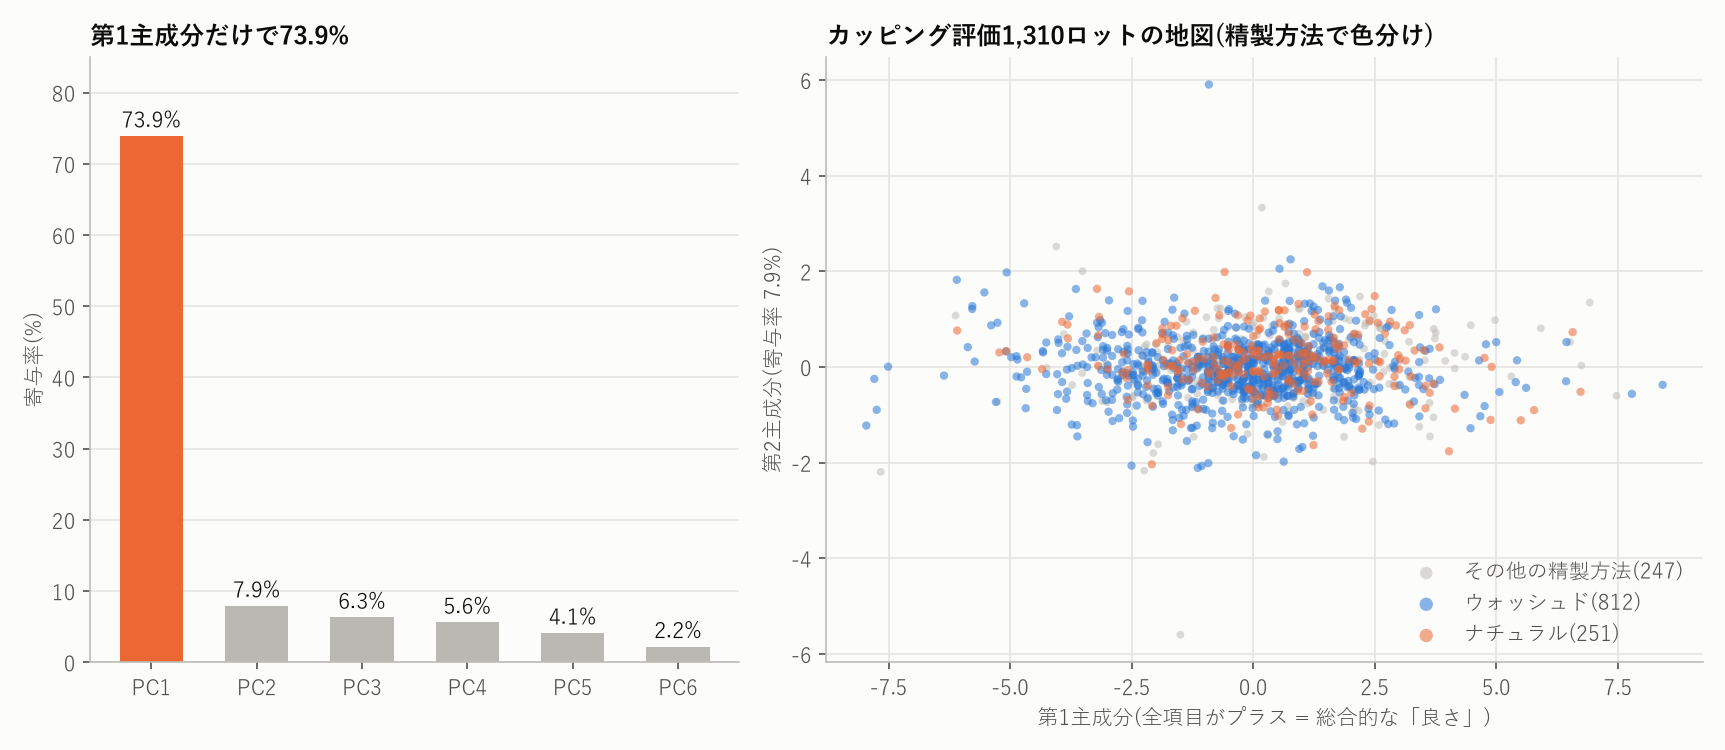
結果は、データAとはまるで違います。
- 第1主成分だけで73.9%(データAは45.1%)。6項目がすべて同じ向きにプラスで、意味は「総合的な良さ」です。味の特徴ではなく、良いコーヒーは何を評価しても良い、という点数のつき方が表れています
- 第2主成分以降は、7.9%、6.3%と小さく、図4の右のように、精製方法(ウォッシュド/ナチュラル)で色を分けても混ざったままです
- 各ロットの平均点を引いて「良さ」を取り除き、味のバランス(個性)だけにして主成分分析をやり直すと、寄与率は27.7%、23.6%、22.6%と3つが並びます。1つの軸には絞れませんでした
- k-means(自動で似た者同士をグループ分けする手法)も試しました。シルエット係数(グループ分けのきれいさ。大きいほど良い)は、2グループで0.36が最大、3グループで0.30、4グループで0.25と、増やすほど下がります。味の自然なグループは見つかりませんでした
プロの点数は、同じ「味のデータ」でも、味の「強さ」を測るデータAとは別物でした。散布図にしても「良い-普通-やや悪い」が1本の線に並ぶだけで、前回のような「甘み系/苦味系」の分かれ方は見えません。
5. 分析3:ランダムフォレストとニューラルネットに「当てさせる」
主成分分析は「地図を描く」手法でした。ここからは、機械学習の本領である予測です。4つの課題を、次の3つの手法で解かせてみました。
- ロジスティック回帰(昔ながらの統計手法。④は同じ立場のリッジ回帰)
- ランダムフォレスト(木500本)
- ニューラルネット(隠れ層32と16のMLP)
データを5分割して、4つで学習して1つで答え合わせをする(交差検証)作業を5回繰り返した平均です。カンニングを防ぐため、答え合わせ用のデータは学習に使っていません。
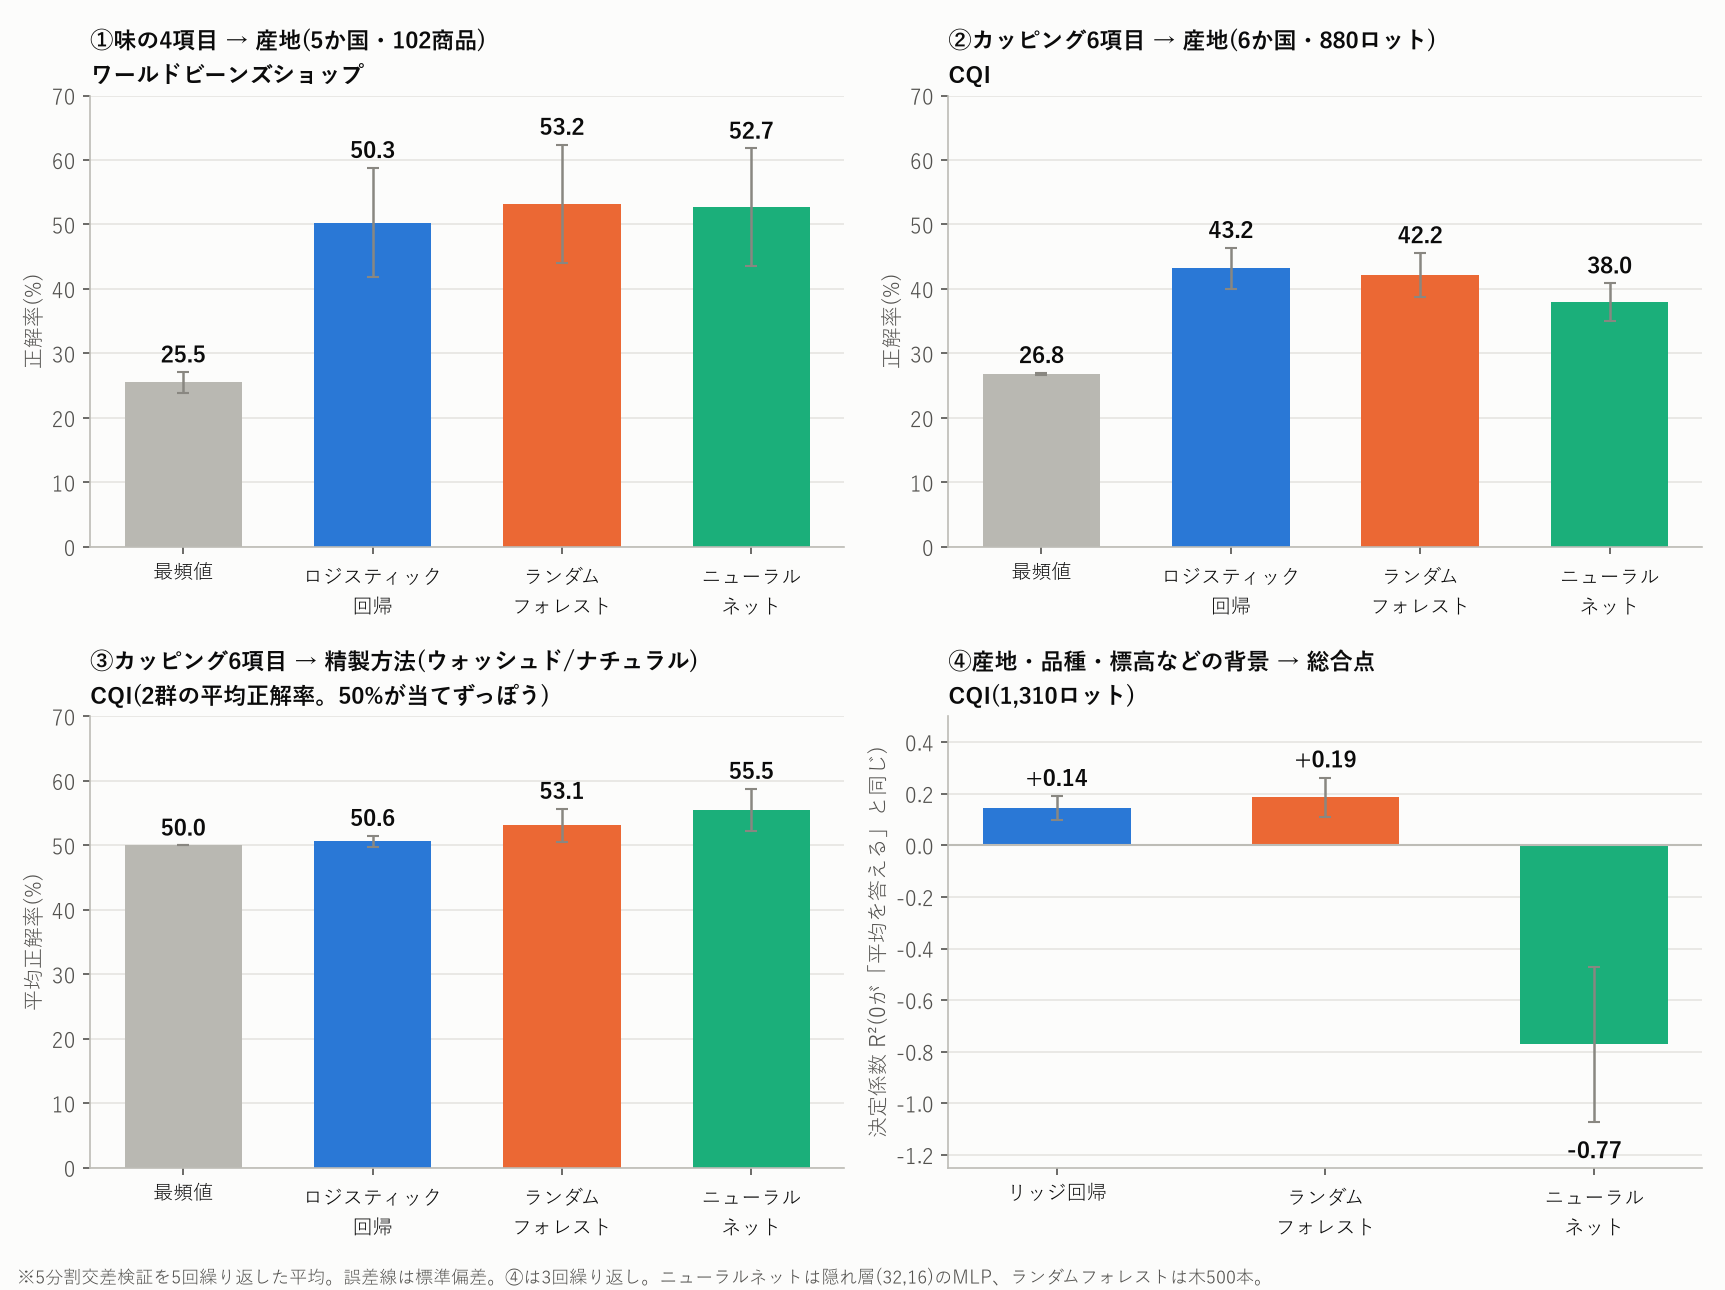
| 課題 | 基準(当てずっぽう) | ロジスティック回帰(④はリッジ回帰) | ランダムフォレスト | ニューラルネット |
|---|---|---|---|---|
| ①味4項目→産地(データA、5か国102商品)正解率 | 25.5% | 50.3% | 53.2% | 52.7% |
| ②カッピング6項目→産地(データB、6か国880ロット)正解率 | 26.8% | 43.2% | 42.2% | 38.0% |
| ③カッピング6項目→精製方法(データB、ウォッシュド対ナチュラル)平均正解率 | 50.0% | 50.6% | 53.1% | 55.5% |
| ④産地・品種・精製方法・標高・収穫年→総合点(データB、1,310ロット)決定係数R² | 0(平均を答える) | +0.14 | +0.19 | -0.77 |
① 味の4つの数字から産地を当てる(データA)
当てずっぽうだと25.5%のところ、どの手法でも5割強まで上がりました。ブラジルは「おとなしい」、インドネシアは「苦味系」と、産地には味の傾向があるのです。ただし3手法の差は3ポイントほどで、答え合わせの分け方によるぶれ(標準偏差で8〜9ポイント)よりずっと小さく、優劣はつきません。ランダムフォレストの変数重要度は、酸味0.31、苦味0.30、コク0.23、甘み0.16で、酸味と苦味が産地の手がかりでした。
② カッピングの6項目から産地を当てる(データB)
当てずっぽう26.8%に対して、4割強。ここでは、ニューラルネットが一番低い38.0%でした。
③ カッピングの点から精製方法を当てる(データB)
ウォッシュドとナチュラルを当てる課題です。2群のバランスをとった正解率は、当てずっぽうの50%に対して50.6〜55.5%。ほぼ当たりませんでした。プロの点数は「どれだけ良いか」の採点なので、精製方法の「らしさ」は点数に出ない、あるいは審査の過程で消えていると考えられます(推測です)。
④ 産地や標高などの「素性」から総合点を当てる(データB)
産地、品種、精製方法、標高、収穫年だけを手がかりに、総合点を予測しました。
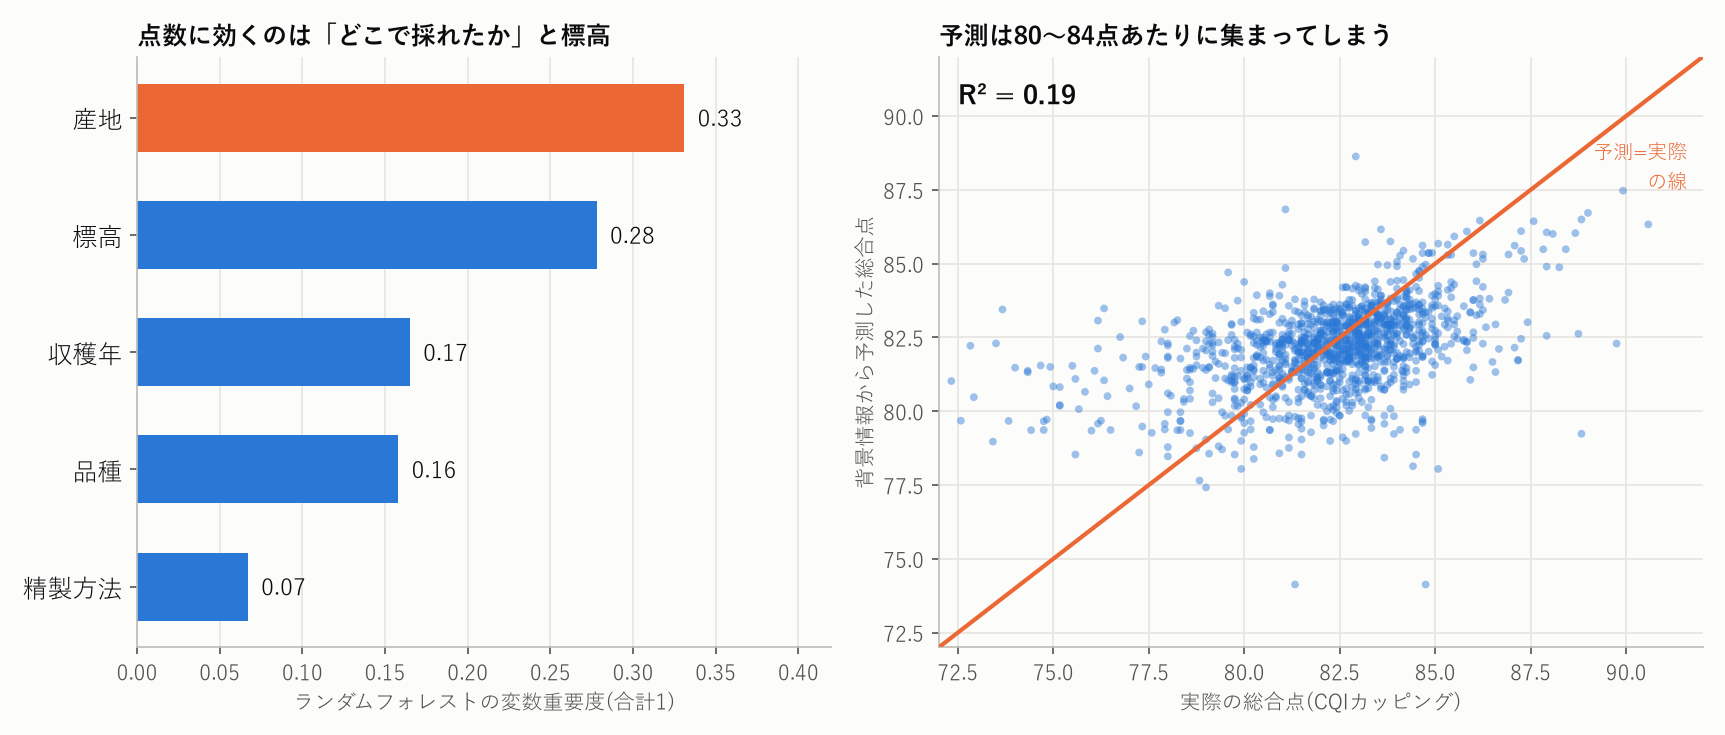
- ランダムフォレストでも、R²は0.19。総合点のばらつきの2割弱しか説明できません。右のグラフで、予測が80〜84点あたりに集まっているのは、良いコーヒーも悪いコーヒーも「だいたい真ん中」と答えているからです
- ニューラルネットは、R²が-0.77。つまり、平均を答えるだけの「0」より悪い結果です。素性の組み合わせが多い(産地や品種の種類が多い)割にデータが1,310件と少なく、学習用のデータを丸暗記して、答え合わせでは外した(過学習)と考えられます。細かく調整すれば改善できそうですが、同じ条件で並べた比較としては、ここがニューラルネットの苦手な領域でした
- ランダムフォレストの変数重要度は、産地(0.33)、標高(0.28)、収穫年(0.17)、品種(0.16)、精製方法(0.07)の順。「どこで採れたか」と標高が効き、精製方法はほとんど効きません。ただし、標高のように連続した数字は、重要度が高く出やすい癖があります。割り引いて見てください
6. 分析4:ニューラルネットで「味の地図」を描くと?
ニューラルネットの見せ場は、本来「予測」より、非線形な関係を学習できる点です。そこで、主成分分析の「地図を描く」役を、ニューラルネットにやらせてみました。6項目を、途中で2つの数字に絞って元に戻す「オートエンコーダ」です。もう一つ、地図づくりの定番t-SNEも並べます。
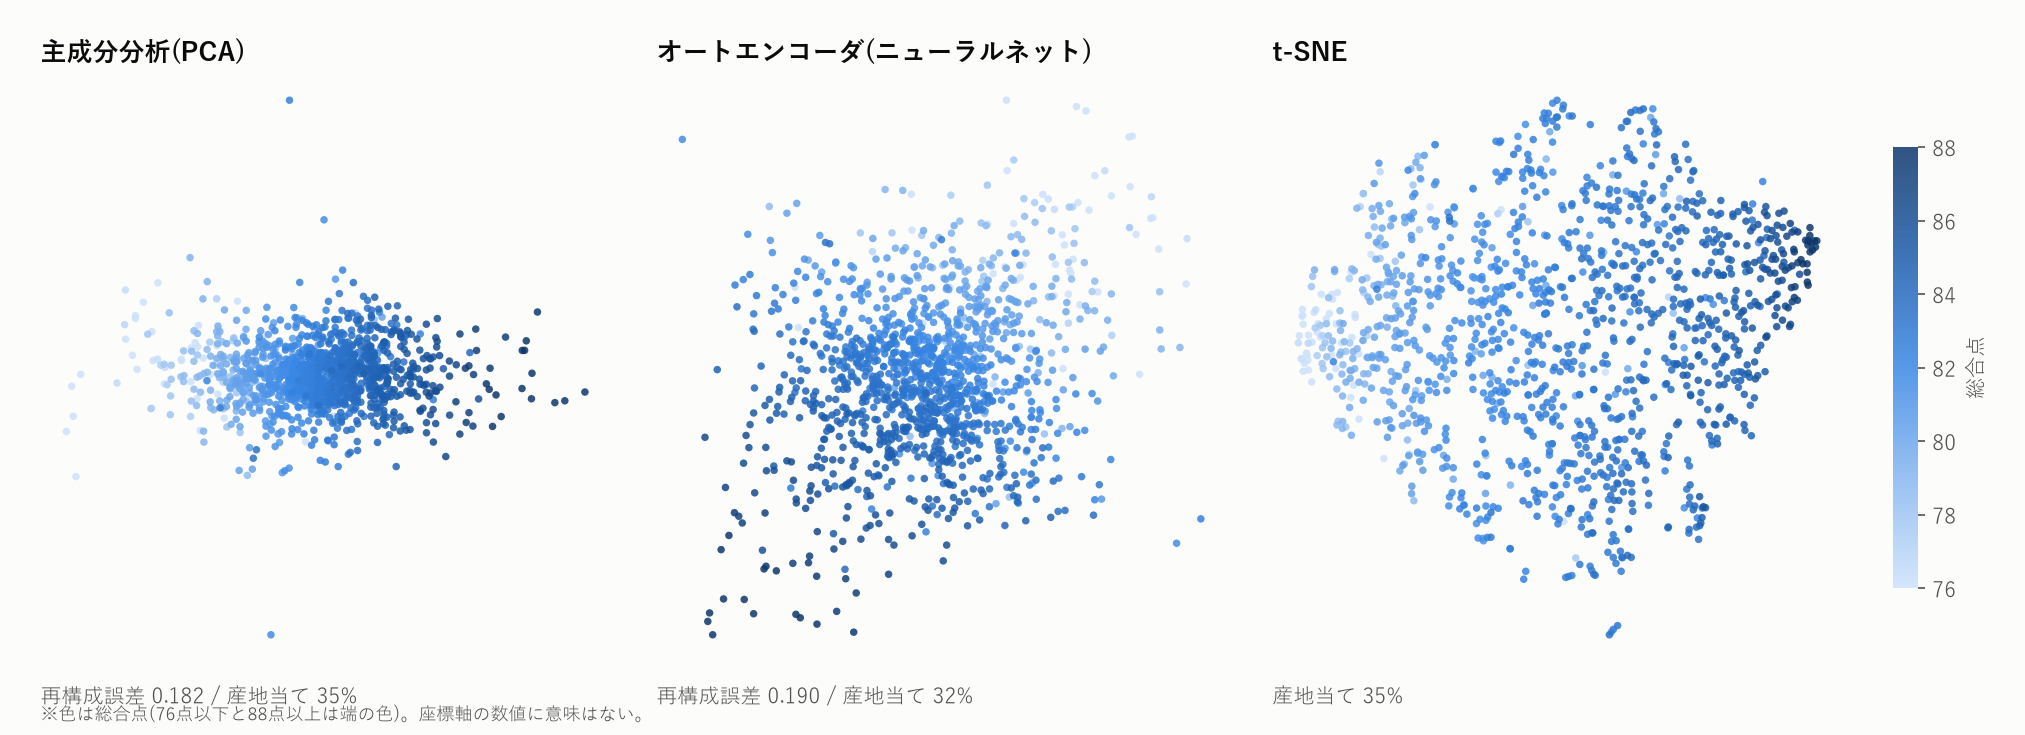
- 元の6項目をどれだけ忠実に復元できるか(再構成誤差。小さいほど良い)は、主成分分析が0.182、オートエンコーダが0.190。ほぼ同じで、主成分分析のほうがわずかに良い結果でした
- 2次元の位置から産地を当てる正解率(近くの点を参考にするk近傍法)は、主成分分析35.0%、オートエンコーダ32.1%、t-SNE34.6%。当てずっぽうの26.8%よりは高いものの、手法による差はありません
- t-SNEは、総合点の高いロットが右上にまとまって見えます。ただし、t-SNEは点どうしの距離に意味がないので、図の形を読みすぎないほうがよい手法です
データの変動の74%が「良さ」の1本の軸に集まっているので、わざわざ曲がった軸を学習する必要がなく、直線の主成分分析で十分だったということだと思います。
7. まとめ:10年後に分かったこと、そして自省
- 主成分分析は、10年たっても現役でした。前回の「横軸は味の全体量」は当たり、分からなかった縦軸の正体は「苦味系 ↔ 甘み系」と分かりました。一方、「右の個性的な側にエチオピア産」という推測は外れました
- ランダムフォレストの強みは、精度より説明です。産地当てでは、ロジスティック回帰と誤差の範囲で同じ。それでも、どの味(酸味と苦味)や、どの素性(産地と標高)が効いたのかを教えてくれます
- ニューラルネットは、今回は出番がありませんでした。187件や1,310件の表データでは、予測でも地図づくりでも、ほかの手法に並ぶか、負けています。「AI=ニューラルネット」というイメージで、何でも任せればよいわけではなさそうです。データが数十万件になれば結果が変わる可能性はありますが、今回はそこまで確かめていません
- 手法より、データの中身が結果を決めていました。星5段階の4項目では、地図上の点が52通りしかなく、同じ点に7商品が重なります。プロのカッピング点は、味の強さではなく「良さ」を測ったもので、地図は1本の線になりました。AIで何を使うか選ぶ前に、「そのデータは何を測っているか」を考えるほうが先だと思い知らされました
反省と注意点
- データAの精製方法は、お店の表記(「ナチュラル」「ウォッシュド」「水洗式」など)を機械的に二つに分けたので、粗い分類です(今回の主な結論には使っていません)
- データBは2018年ごろに公開された、2012〜2017年収穫が中心のロットです。2023年5月版(Kaggle)は、今回は使っていません。最新の評価データで確かめ直すのは、宿題にします
- 調査で見つかった関連研究のうち、MDPIの論文「Predicting Coffee Sensory Quality Using Machine Learning and Synthetic Terroir-Based Data」は、原典のページを開けず、数字を確認できませんでした。そのため、数値は引用していません
この先:コーヒーの採点方法が変わった
最後に、データの世界の変化です。SCA(スペシャルティコーヒー協会)は2024年11月、新しい評価方式「Coffee Value Assessment(CVA)」を正式採用しました。2004年から使われてきた従来のカッピングフォームを置き換えるもので、「何が感じられるか(記述的評価)」と「好ましいか(情動的評価)」を別々に採点する考え方です。
今回のデータBの「良さ」の点数は、旧方式のものです。今後は、味の記述と評価が別々に記録されたデータが増えていくと考えられます。そうなれば、今回の主成分分析で見えなかった「味の個性の地図」が、プロのデータでも描けるようになるかもしれません。次に挑戦するなら、テイスティングコメントの文章をAIで数値にして、地図に乗せる方法です。10年後にまた、やり直してみたいと思います。
参考・出典
- ワールドビーンズショップ(商品ページの「味覚レベル」、2026年10月取得)
- GitHub: jldbc/coffee-quality-database(CQI公開データ)、Coffee Quality Institute データベース
- Kaggle: Coffee Quality Data (CQI May-2023)(今回は使用せず)
- SCA officially adopts new cupping forms and standards(Daily Coffee News、2024年11月5日)、SCA Coffee Value Assessment
- コーヒーの味を散文図にする(2016年)
※分析はPythonのscikit-learn(PCA、k-means、ロジスティック回帰、ランダムフォレスト、MLP)で行い、データAは4項目を標準化してから主成分分析にかけました。データBは総合点が0の異常値1件を除いた1,310ロット(産地の課題は上位6か国の880ロット、精製方法の課題はウォッシュドとナチュラルの1,063ロット)。精度はすべて交差検証の平均で、乱数は固定してあります。図1とアイキャッチはNotebookLMで生成し、グラフ(図2〜7)は実データから作成しました。